Inferencia de IA open source con soporte empresarial: El Stack de Red Hat AI de abajo hacia arriba
El problema: el LLM no es lo difícil, la operación sí
Llevar un modelo de lenguaje a producción en una empresa ya no es un problema de «¿qué modelo uso?». Es un problema de plataforma: cómo lo sirvo rápido, cómo lo escalo sin quemar GPUs, y cómo controlo quién lo consume y cuántos tokens gasta.
En banca y seguros esto se vuelve crítico. Los datos no pueden salir del perímetro, el regulador pregunta por trazabilidad y finanzas pregunta por el costo por token. Pagar una API externa por cada consulta funciona en el piloto, pero no siempre en la escala.
La buena noticia es que hoy existe una pila 100% open source que resuelve cada una de esas capas. Y la mejor noticia, es que puedes correrla con soporte empresarial de Red Hat. En este post la recorremos de abajo hacia arriba la arquitectura de referencia.
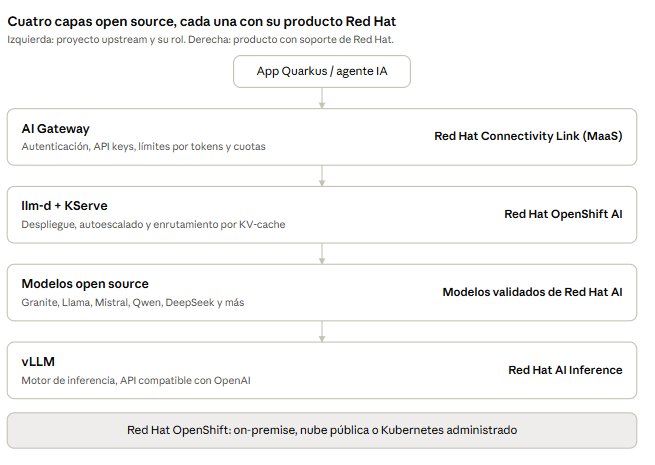
La petición entra por arriba y baja capa por capa hasta la GPU. Cada capa es un proyecto open source con su equivalente empresarial de Red Hat, y todas corren sobre OpenShift.
Capa 1 — vLLM: el motor de inferencia
vLLM es el motor que carga el modelo en la GPU y genera los tokens. Si lo comparamos con el mundo Java, vLLM es la JVM: no le importa qué aplicación corres, se encarga de ejecutarla de la forma más eficiente posible.
Su ventaja viene de dos ideas clave:
- PagedAttention: gestiona la memoria del KV-cache como un sistema operativo gestiona la memoria virtual, por páginas. Menos memoria desperdiciada significa más usuarios concurrentes por GPU.
- Continuous batching: no espera a que termine un lote para empezar el siguiente; va metiendo peticiones nuevas a medida que se liberan espacios.
Además expone una API compatible con OpenAI. Esto es oro para los equipos de desarrollo: el mismo código con LangChain4J o Quarkus que hoy apunta a OpenAI puede apuntar a tu vLLM interno cambiando solo la URL base.
vLLM es hoy un estándar de facto: en MLPerf Inference v6.0 lo usaron 20 participantes, frente a 5 en la edición anterior (fuente). La versión empresarial es Red Hat AI Inference (antes Red Hat AI Inference Server), con imágenes certificadas sobre RHEL para GPUs NVIDIA, AMD y otros aceleradores.
Capa 2 — Los modelos: libertad de elegir
Sobre vLLM corre el modelo que tú elijas. Esa es la gran diferencia con una API cerrada: el modelo es un artefacto que versionas, despliegas y auditas, igual que un JAR en tu repositorio de artefactos.
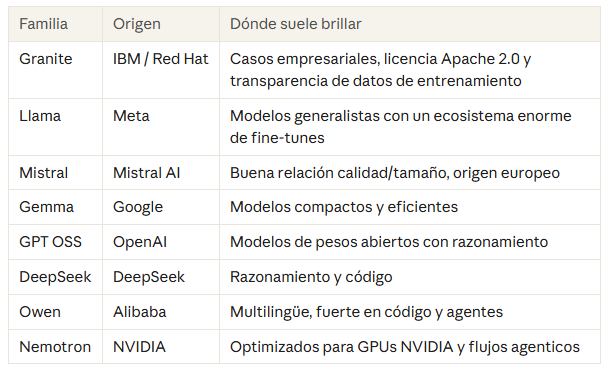
Red Hat publica versiones validadas y optimizadas (por ejemplo, cuantizadas en FP8 o INT4) de muchos de estos modelos en su repositorio de Hugging Face. Eso significa menos GPU por modelo y resultados probados sobre la plataforma.
El consejo del Buga: no te cases con un modelo. Diseña la plataforma para poder cambiarlo cuando salga uno mejor, porque va a salir.
Capa 3 — KServe + llm-d: de servir un modelo a operar inferencia
Un vLLM aislado es un servidor. Cuando tienes decenas de réplicas, varios modelos y GPUs caras, necesitas un orquestador. Aquí entran dos proyectos que trabajan juntos.
KServe es la capa de despliegue y ciclo de vida sobre Kubernetes. Defines un recurso declarativo y KServe crea los pods, el autoescalado y el endpoint. Desde la versión 0.16 incluye LLMInferenceService, un recurso pensado específicamente para LLMs (fuente).
llm-d es la inteligencia de enrutamiento. Lo lanzaron en mayo de 2025 Red Hat, Google Cloud, IBM Research, NVIDIA y CoreWeave, y ya es proyecto Sandbox de la CNCF (fuente). Si vLLM es la JVM, llm-d es el balanceador que sabe qué tiene cada JVM en memoria. Aporta:
- Enrutamiento consciente del KV-cache: envía la petición a la réplica que ya tiene en caché el prefijo del prompt (por ejemplo, el mismo system prompt de un agente). Menos recálculo, menor latencia.
- Inferencia desagregada: separa la fase de prefill (leer el prompt) de la fase de decode (generar tokens) en pods distintos, para dimensionar cada una según su perfil.
- Escalado por carga real de inferencia, no solo por CPU.
La división de responsabilidades es limpia: KServe gobierna el ciclo de vida, llm-d decide a qué réplica va cada petición y vLLM ejecuta. Un round-robin tradicional no sabe nada de cachés; llm-d sí.
Capa 4 — AI Gateway: gobierno y Models-as-a-Service
La capa superior es la puerta de entrada. Sin ella, cada equipo levanta su propio modelo, nadie sabe cuántos tokens se consumen y aparece la temida «shadow AI». Con ella, la IA se ofrece como un servicio interno, igual que un API Manager ofrece APIs.
En Red Hat OpenShift AI esto se llama Models-as-a-Service (MaaS), y su gateway de IA está construido sobre Red Hat Connectivity Link (basado en el proyecto Kuadrant y la Gateway API de Kubernetes). OpenShift AI 3.4 lo incluye sin costo adicional (fuente). Lo que te da:
- Autenticación y API keys de autoservicio para los desarrolladores.
- Límites por tokens, no solo por peticiones: puedes definir, por ejemplo, cuántos tokens por minuto consume cada equipo o nivel de suscripción.
- Cuotas y chargeback para saber qué área gasta cuánto.
- Un solo punto de entrada para modelos propios y, si lo necesitas, modelos externos.
Un detalle importante: la limitación por tokens usa el conteo real que reporta el modelo, así que una respuesta larga «cuesta» más cuota que una corta (fuente). Cuando se pasa el límite, el cliente recibe un HTTP 429, como cualquier API bien gobernada.
Qué aporta Red Hat: del upstream al soporte empresarial
Todo lo anterior se puede descargar de GitHub hoy mismo. La pregunta que hace un banco no es «¿se puede?», sino «¿quién me responde a las 3 a.m. cuando falle?». Ahí está el valor del modelo de suscripción de Red Hat: el mismo código open source, empaquetado, probado en conjunto y con soporte.
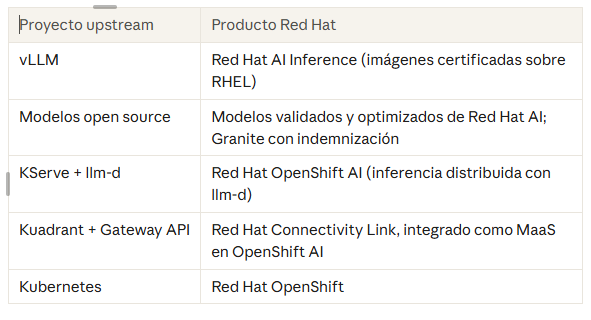
Lo que ganas con la suscripción:
- Pila validada en conjunto: versiones de vLLM, KServe y llm-d probadas para funcionar juntas, sin el infierno de dependencias.
- Soporte y ciclo de vida: parches de seguridad, CVEs atendidos y una ruta de actualización clara.
- Nube híbrida real: la misma pila corre on-premise, en nubes públicas y, desde Red Hat Summit 2026, Red Hat AI Inference también en Kubernetes administrados como CoreWeave y Azure (fuente).
- Soberanía de datos: los prompts y respuestas no salen de tu infraestructura.
- Sin lock-in: si mañana decides irte, te llevas el mismo código upstream.
Aterricemos: un asistente para un banco o una aseguradora
Imagina una aseguradora en Lima que quiere un agente de atención de siniestros y, además, un asistente de código para sus desarrolladores. Con esta arquitectura, el recorrido de una petición es:
- La app Quarkus del agente llama al endpoint compatible con OpenAI del AI Gateway, con su API key.
- El gateway valida identidad, revisa la cuota de tokens del equipo y enruta al modelo pedido.
- llm-d elige la réplica de vLLM que ya tiene en caché el system prompt del agente.
- vLLM genera la respuesta con un modelo Granite o Qwen desplegado por KServe dentro del clúster.
- El gateway descuenta los tokens consumidos y devuelve la respuesta. Ningún dato salió del perímetro.
Desplegar el modelo es declarativo. Un ejemplo ilustrativo de InferenceService con el runtime de vLLM (ajusta nombres y almacenamiento a tu entorno):
apiVersion: serving.kserve.io/v1beta1

kind: InferenceService

metadata:

name: granite-siniestros

annotations:

serving.kserve.io/deploymentMode: RawDeployment

spec:

predictor:

model:

modelFormat:

name: vLLM

runtime: vllm-cuda-servingruntime

storageUri: oci://registry.example.com/models/granite:latest

resources:

limits:

nvidia.com/gpu: "1"
Para cargas grandes con varias réplicas, el mismo modelo se despliega con LLMInferenceService y llm-d toma el enrutamiento.
Y del lado del desarrollador Java, nada cambia respecto a usar OpenAI. Con Quarkus LangChain4J basta apuntar a la URL del gateway:
quarkus.langchain4j.openai.base-url=https://maas.mi-banco.internal/llm/granite-siniestros/v1

quarkus.langchain4j.openai.api-key=${MAAS_API_KEY}

quarkus.langchain4j.openai.chat-model.model-name=granite-siniestros
Como siempre digo: si ya tienes APIs, ya tienes el 80% de un agente. Esta pila pone el otro 20% en tu propio clúster.
La IA generativa empresarial ya tiene su stack de referencia, y es open source de punta a punta: vLLM ejecuta, los modelos abiertos razonan, KServe y llm-d orquestan, y el AI Gateway gobierna. Cada capa se puede reemplazar sin tirar las demás.
Lo que Red Hat suma es lo que una entidad regulada necesita para dormir tranquila: componentes probados juntos, soporte, ciclo de vida y la libertad de correrlo donde estén tus datos.
La pregunta ya no es si puedes tener tu propio «OpenAI interno». Es cuándo empiezas.
¿En tu organización la IA ya pasa por un gateway, o cada equipo tiene su propia API key? Cuéntame en los comentarios.
Fuentes
- Combining KServe and llm-d for optimized generative AI inference — Red Hat Developer
- Scaling enterprise AI: Models-as-a-Service with Red Hat OpenShift AI 3.4 — Red Hat Blog
- Introducing Models-as-a-Service in OpenShift AI — Red Hat Developer
- Red Hat AI Inference brings llm-d to any managed Kubernetes — Red Hat Blog
- State of the Model Serving Communities, abril 2026
Entradas relacionadas
-
 Repositorios de Datos para Inteligencia Artificial
-
 Entendiendo las APIs de Inferencia: Qué Son y Por Qué Son Importantes en la IA
-
 Wells Fargo: Cargas de trabajo de IA/ML con OpenShift: escalando la innovación en la industria de servicios financieros
-
 Modelo LLM con PodMan AI Lab y Java Quarkus con LangChain4J
Sobre el Autor

Jose Luis Bugarin
Pragmático, soy de leer y hacer y no esta demás mencionar que las opiniones son mías :) #telodijoelbuga